Votre application fonctionne encore. Les commandes arrivent, les collaborateurs se connectent, les exports partent. Pourtant, personne ne sait vraiment qui pourrait intervenir demain : le développeur historique a quitté l’entreprise, l’agence a arrêté la maintenance ou votre prestataire ne répond plus.
La difficulté commence souvent avant la première panne. Une évolution devient impossible à chiffrer, une alerte de l’hébergeur reste sans réponse, un accès manque au moment de renouveler un service. L’entreprise possède un outil utile, mais sa capacité à le maintenir s’est réduite.
Pour reprendre un projet PHP, le premier objectif est de retrouver cette capacité d’action : savoir ce qui tourne, pouvoir le restaurer et disposer d’une méthode fiable pour le modifier. La décision de moderniser ou de réécrire vient ensuite, lorsque les risques et les règles métier sont compris.
Commencer par ce qui ferait réellement défaut à l’entreprise
Avant de parler de framework, choisissez les opérations que l’application doit absolument assurer. Que se passerait-il si elle devenait indisponible demain matin ? Pourriez-vous traiter les commandes autrement, retrouver les coordonnées des clients, préparer la facturation ou poursuivre la production ?
Cette conversation avec les utilisateurs oriente la reprise. Un tableau de bord lent et un export comptable incorrect ne présentent pas le même risque. La taille du code ne dit pas non plus combien l’entreprise en dépend.
Prenons un exemple illustratif : une PME utilise une application PHP pour recevoir des demandes, calculer un tarif et transmettre chaque dossier à son outil de gestion. Le formulaire public paraît être le cœur du système. Mais le traitement nocturne qui transmet les dossiers peut avoir davantage d’importance : s’il échoue silencieusement, les équipes poursuivent leur travail sur des données incomplètes.
Le nouveau prestataire doit donc examiner le parcours complet, y compris les opérations qui ne s’affichent dans aucun écran. Cette compréhension sert ensuite à choisir les vérifications prioritaires et les interlocuteurs qui valideront les changements.
Récupérer les accès, puis établir ce qu’ils permettent
Un accès FTP est utile pour récupérer des fichiers. Il ne donne pas nécessairement la base de données, la configuration du serveur, les sauvegardes ou la maîtrise du nom de domaine. De même, un compte administrateur dans l’application ne permet pas toujours de la remettre en service après un incident.
La première collecte doit couvrir cinq ensembles :
- Le code : dépôt Git, archives disponibles, fichiers en production et dépendances nécessaires à leur fonctionnement.
- Les données : base de données, documents téléversés, stockage externe et sauvegardes.
- L’exploitation : hébergement, domaine, configuration, tâches planifiées et procédure de déploiement.
- Les services connectés : paiement, e-mail, CRM, API et comptes de facturation correspondants.
- Les personnes et les repères métier : utilisateurs clés, incidents connus, échéances et documentation existante.
Pour chaque élément, il faut préciser qui contrôle le compte, qui peut intervenir et ce qui reste inaccessible. Les secrets se transmettent par un canal adapté, jamais dans une demande publique ni dans le dépôt de code.
La rotation des mots de passe et des clés d’API se prépare aussi. Changer une clé sans identifier ses consommateurs peut interrompre un paiement ou une synchronisation. On remplace les accès avec un plan de vérification, plutôt qu’en une seule opération aveugle.
Sans Git, la reprise reste possible, mais il manque une partie de la mémoire
Un dossier récupéré sur le serveur peut constituer un point de départ. Il faut toutefois savoir s’il représente l’application complète : certains fichiers peuvent être générés, stockés ailleurs ou dépendre d’une configuration propre à la machine. Des corrections ont parfois été faites directement en production, sans être reportées dans une archive plus ancienne.
La méthode consiste à conserver une photographie protégée de l’existant, puis à comparer les versions disponibles. Les configurations contenant des secrets et les données des utilisateurs restent hors du futur dépôt. Un historique Git peut ensuite commencer à partir d’un état identifié : il suivra les prochaines interventions, mais ne recréera pas les décisions passées. La documentation officielle de Git distingue bien la création d’un dépôt et la récupération d’un dépôt existant.
Un autre piège concerne les bibliothèques PHP. Si le projet utilise Composer, le fichier composer.lock indique les versions exactes retenues. La documentation de Composer précise qu’une installation fondée sur ce fichier les conserve, tandis qu’une mise à jour peut les modifier. Reconstituer l’environnement et actualiser ses composants sont donc deux opérations distinctes.
L’absence de Git n’impose pas une réécriture. Elle augmente l’incertitude et demande davantage de précautions pour construire un premier état de référence fiable.
Audit, reprise et réécriture : trois décisions différentes
L’audit sert à décider. Il évalue ce qui est accessible, ce qui menace la continuité et ce qui empêche une évolution. Son résultat doit faire apparaître les constats établis, les vérifications incomplètes et les actions proposées. Une longue liste de défauts sans ordre de priorité aide peu un dirigeant.
La reprise installe une capacité d’exploitation : restaurer une copie, comprendre les traitements essentiels, préparer une modification et la mettre en ligne avec des contrôles. Elle peut inclure des corrections urgentes. Son périmètre doit distinguer ces interventions de la maintenance future.
La réécriture remplace tout ou partie du système. Elle peut être pertinente si un composant est irrécupérable, si les besoins ont profondément changé ou si les limites de l’existant bloquent durablement l’activité. Mais elle oblige à retrouver les exceptions métier, reprendre les données et organiser la bascule. Ces travaux ne disparaissent pas avec le choix d’une technologie récente.
L’âge de PHP ou du framework compte dans l’évaluation. Une version en fin de vie ne reçoit plus le support du projet PHP ; le calendrier officiel des versions supportées permet de vérifier ce point. Cela justifie une trajectoire de mise à niveau, dont l’urgence dépend aussi de l’exposition et des risques observés. Le saut vers la version la plus récente doit être préparé et testé.
Un calendrier indicatif pour les 30 premiers jours
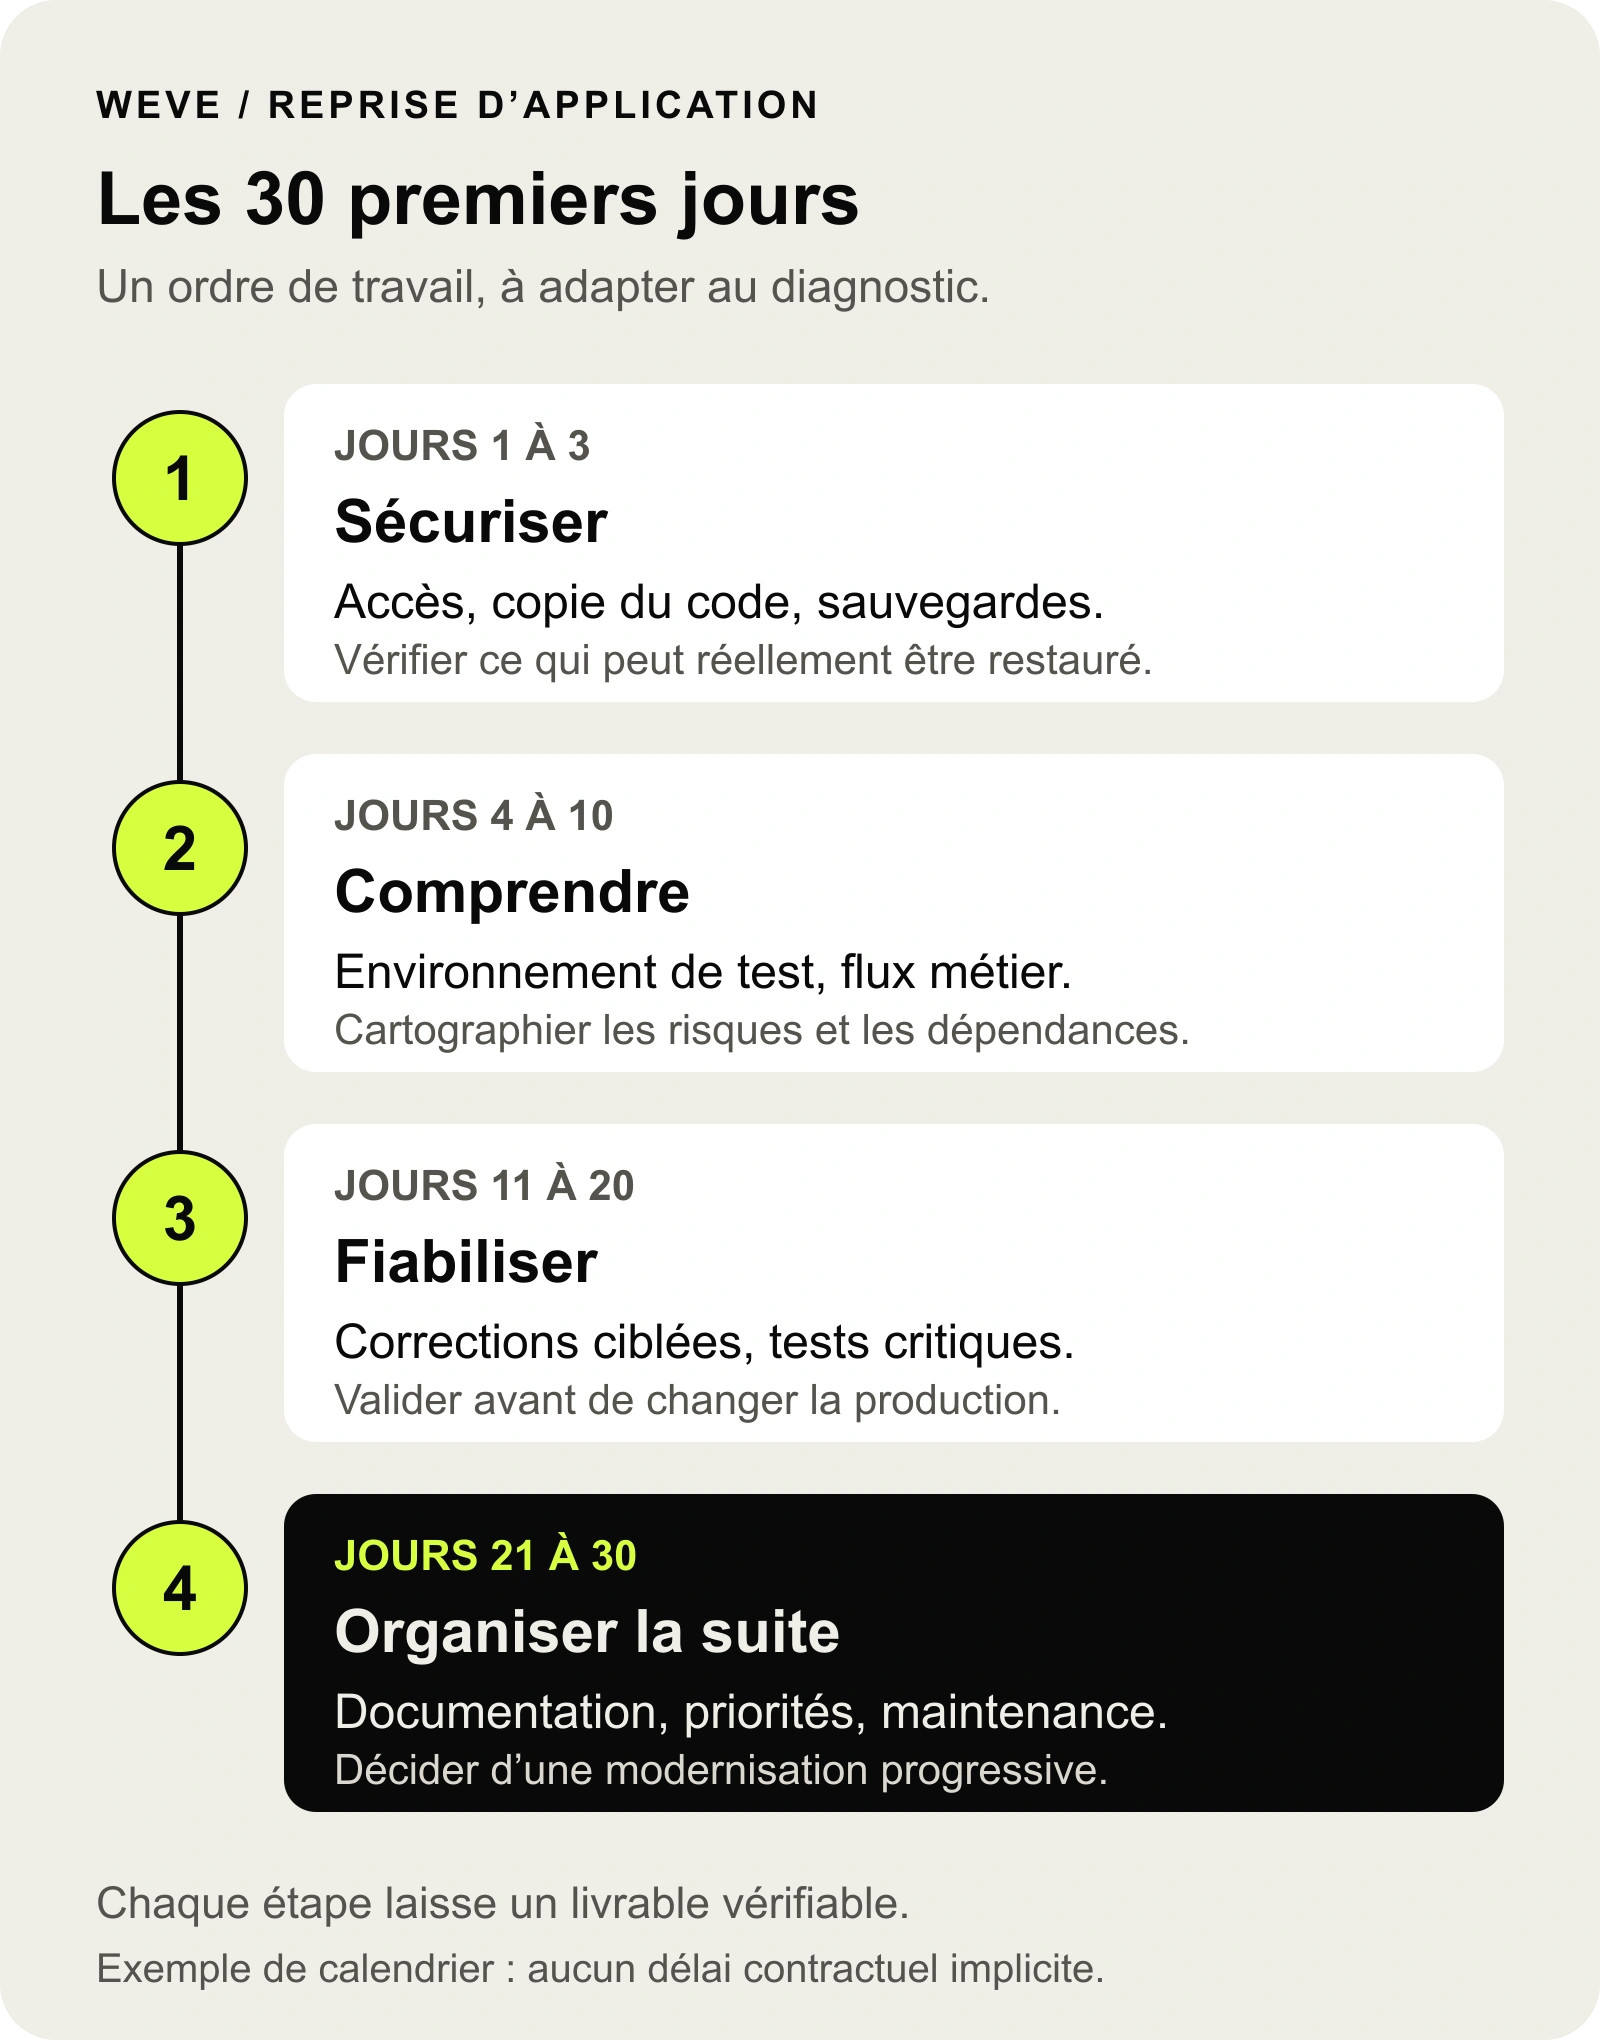
Le calendrier suivant donne des repères de décision. Il suppose que les accès sont disponibles et que l’application peut être examinée. Une panne majeure, une base volumineuse ou des comptes manquants peuvent modifier l’ordre et la durée des phases. Ce n’est pas une promesse de reprise complète en un mois.
Jours 1 à 3 : protéger et délimiter
L’équipe rassemble les accès, identifie les opérations critiques et conserve une copie du code, des données et de la configuration nécessaire. Elle examine les sauvegardes et les alertes immédiates. Vous devez pouvoir répondre à deux questions : qu’est-ce qui est récupérable aujourd’hui, et où subsiste un risque de perte ou d’interruption ?
Si l’application est déjà en panne, le rétablissement passe en priorité. Les interventions sont alors consignées afin de garder une trace de ce qui a été changé dans l’urgence.
Jours 4 à 10 : reproduire et observer
Une copie isolée permet de vérifier qu’on sait reconstruire le système. Elle doit empêcher les envois d’e-mails réels, les paiements et les écritures vers les outils de production. Les données utilisées sont limitées ou masquées selon les besoins.
La restauration révèle souvent les dépendances oubliées : extension PHP, répertoire externe, service d’e-mail ou programme lancé par le serveur. Une archive complète en apparence peut ne pas suffire au redémarrage. Le résultat attendu est une procédure reproductible, avec ses éventuelles limites documentées.
Jours 11 à 20 : vérifier les flux et corriger par priorité
L’équipe suit les opérations retenues avec les utilisateurs : création d’un dossier, changement de statut, export, transmission à un partenaire. Elle observe aussi les tâches automatiques et les erreurs. Quelques vérifications ciblées sur ces parcours apportent un filet de sécurité avant les premières corrections.
Chaque intervention doit avoir un résultat attendu et un contrôle associé. Pour une transmission de données, cela peut signifier vérifier non seulement que l’appel part, mais que le destinataire reçoit le bon dossier, sans doublon.
Jours 21 à 30 : choisir une trajectoire et organiser le suivi
Le bilan distingue les urgences traitées, les risques restants et les évolutions possibles. Il précise qui surveille les incidents, comment une demande est priorisée et comment une modification sera livrée.
Le bon résultat peut être une stabilisation assortie d’un programme de maintenance et de modernisation, la rénovation progressive d’un module ou une étude de remplacement. Vous devez disposer d’options compréhensibles, avec leurs dépendances et les inconnues qui affectent encore le budget.
Ce qui fait varier le prix et le délai
Deux applications comportant le même nombre d’écrans peuvent demander des efforts très différents. Le coût dépend notamment de la capacité à reconstruire l’environnement, du nombre de services connectés, de la qualité des données et de la possibilité de valider les règles avec les utilisateurs.
Un dossier sans documentation mais avec un dépôt cohérent et un environnement de test peut être plus simple à reprendre qu’un projet bien présenté dont le serveur contient des modifications introuvables ailleurs. Une contrainte de disponibilité augmente également le travail de préparation de chaque changement.
Une proposition sérieuse précise ce que couvre le diagnostic, ses livrables et son point de décision. Elle peut ensuite chiffrer les actions sur un périmètre vérifié. Elle doit indiquer les hypothèses qui restent ouvertes : accès à obtenir, comportement à confirmer, volume à mesurer. Cette séparation permet d’engager un premier travail utile sans prétendre connaître d’avance toute la reprise.
Préserver les règles métier avant de remplacer la technique
La connaissance des utilisateurs complète ce que montre le code. Une règle étrange peut traduire un accord commercial, une contrainte comptable ou une exception nécessaire. La supprimer parce qu’elle paraît mal conçue peut produire une régression difficile à détecter.
La plateforme SaaS métier présentée par WEVE rassemble modèle de données, règles de gestion, imports, flux partenaires, exports et maintenance évolutive. Ce cas public porte sur la conception et l’évolution d’une plateforme Laravel. Il illustre la densité des liens entre ces fonctions : remplacer un traitement exige de comprendre les données qu’il reçoit et celles qu’il fournit aux autres modules.
Pour une application Laravel, notre guide reprendre une application Laravel sans tout réécrire approfondit les questions propres au framework. La démarche présentée ici s’applique aussi à un PHP sur mesure ou à un autre framework : partir du fonctionnement réel, puis préparer des changements vérifiables.
Préparer votre premier échange avec WEVE
Vous pouvez commencer avec un dossier incomplet. Décrivez ce que fait l’application, qui l’utilise, pourquoi la maintenance s’est interrompue et quelle échéance vous préoccupe. Ajoutez la liste des accès disponibles et les incidents connus. Ne transmettez pas de mot de passe à cette étape.
Nous pourrons définir un diagnostic adapté, puis un plan de reprise fondé sur l’état observé. L’enjeu est de retrouver un outil que vous pouvez faire fonctionner, faire évoluer et confier avec un cadre clair.
Votre application PHP doit changer de prestataire ?